Уявімо, що вам потрібно швидко розібратися в незнайомій темі. Раніше довелося б відкривати Google, переглядати десятки результатів, переходити між сайтами, шукати статистику, першоджерела й академічні дослідження. Тепер можна просто поставити запитання AI-пошуковикам, зокрема Perplexity — і за кілька секунд отримати структуровану відповідь із посиланнями. Він не просто знаходить вебсторінки, а аналізує їх за допомогою мовних моделей і формує готову відповідь із посиланнями на джерела.
Але поява цитат не означає, що отриманій відповіді можна автоматично довіряти. Нейромережа Perplexity може неправильно інтерпретувати джерело, змішати інформацію з різних матеріалів або зробити висновок, якого першоджерело насправді не підтверджує. Тому важливо розуміти не лише те, як шукати інформацію за допомогою Perplexity, а й те, як її перевіряти.
У цьому матеріалі розберемо, що таке Perplexity, як це працює, чим відрізняються її режими пошуку, як формулювати ефективні запити та, головне, як перевіряти цитати й оцінювати надійність знайдених джерел.
Що таке Perplexity AI
Perplexity AI — це AI-пошуковик, який поєднує звичайний вебпошук із можливостями великих мовних моделей LLM.
Наприклад, запитаймо пошуковик: «Які країни Європи найбільше інвестували в сонячну енергетику у 2025 році?». Звичайний пошук покаже сторінки, де можна знайти відповідь. Perplexity спробує самостійно зібрати дані з кількох джерел, порівняти їх і коротко підсумувати результат, а користувач зможе перейти за цитатами та перевірити інформацію.
Саме це відрізняє можливості Perplexity AI від класичного пошуковика: він не лише знаходить інформацію, а й синтезує її у відповідь.
| Інструмент | Що отримує користувач |
| Традиційний пошуковик | Список посилань |
| AI-чат без вебпошуку | Відповідь, сформовану моделлю |
| Perplexity пошук | Синтезовану відповідь + результати вебпошуку + посилання на джерела Perplexity |
Це робить Perplexity особливо зручним для ситуацій, коли потрібно не просто знайти сторінку, а швидко розібратися в темі.
Водночас пошук інформації в Perplexity не варто сприймати як безпомилковий «пошуковик правди». Мовна модель може неправильно інтерпретувати знайдений матеріал або зробити висновок, якого джерело насправді не підтверджує. Тому одна з ключових навичок під час роботи з Perplexity — перевіряти наведені цитати та переходити до першоджерел.
Як працює Perplexity
Сервіс не просто шукає сторінки за ключовими словами, а намагається зрозуміти запит, знайти релевантну інформацію, проаналізувати її та сформувати зручну для людини відповідь.
Спрощено процес можна уявити як ланцюжок:
запит користувача → пошук у вебі → відбір джерел → аналіз інформації LLM → формування відповіді → цитати та посилання.
Наприклад, замість запиту «штучний інтелект ринок» можна запитати: «Яким був світовий ринок генеративного AI у 2025 році? Наведи оцінки щонайменше трьох незалежних дослідницьких організацій, вкажи методологію та посилання на першоджерела».
У другому випадку Perplexity має не просто знайти сторінки зі словами «AI market», а зрозуміти, яка саме інформація потрібна, знайти релевантні матеріали та синтезувати їх.
Для складніших запитів Perplexity може виконувати кілька пошукових кроків, читати велику кількість матеріалів і будувати звіт. У Research mode, за документацією Perplexity, система може автоматично виконувати десятки пошуків і опрацьовувати сотні джерел.
Важливо, однак, розуміти: LLM не є джерелом істини. Модель відповідає на основі інформації, яку система знайшла та проаналізувала. Якщо джерела неповні, застарілі або неправильно інтерпретовані, помилковою може стати й фінальна відповідь.
Як користуватися Perplexity AI
Почати можна без складного налаштування: достатньо відкрити Perplexity та поставити запитання. Але якщо зареєструватися за допомогою електронної пошти або Google-акаунта, то після входу можна зберігати історію пошуку та користуватися додатковими функціями сервісу.
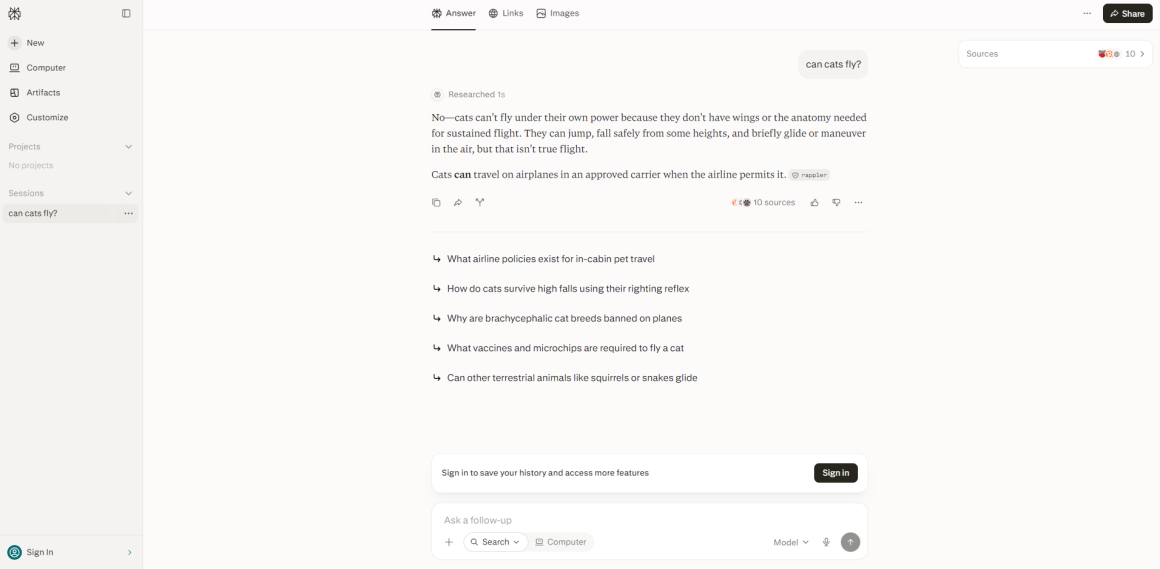
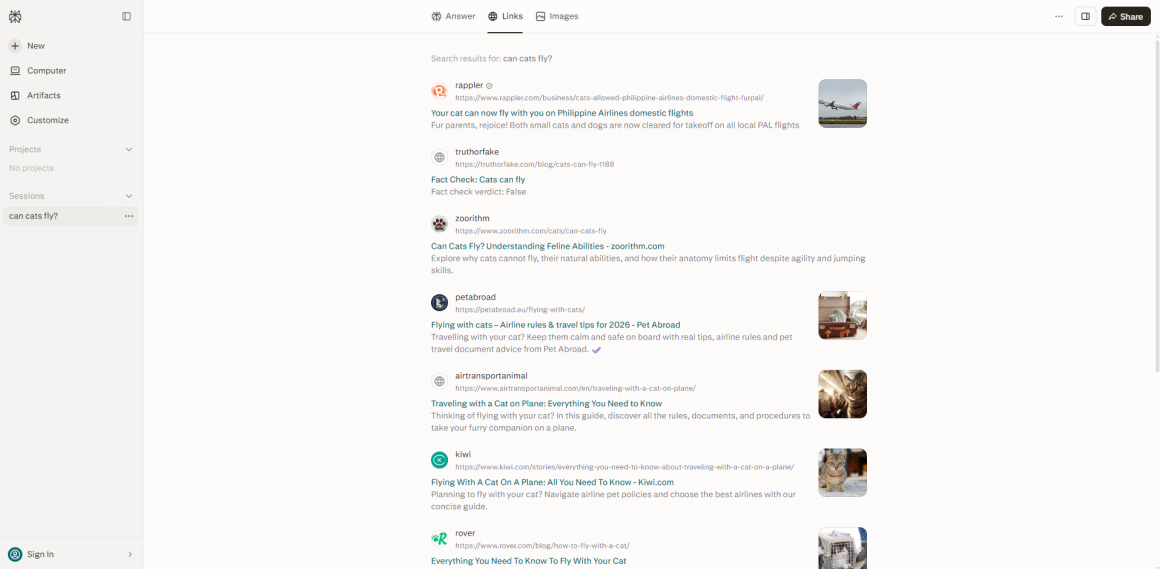
В інтерфейсі можна переключатись між різними вкладками: відповідями, посиланнями та зображеннями
У сервісу є безплатний план. Станом на вересень 2026 року Standard/Free включає базовий пошук, історію пошуку, обмежену кількість Pro Searches, обмежені завантаження файлів та Research-запити.
Точні ліміти можуть змінюватися, але актуальна інформація про тарифи Perplexity зараз вказує, зокрема, 3 Pro Searches на день і 1 Research query на місяць для Free.
Окремі функції можна використовувати навіть без авторизації, але для збереження сесій та доступу до частини можливостей потрібен акаунт.
Платний Pro-план дає більше доступу до Pro Search і Research, додаткові моделі, більші ліміти роботи з файлами та інші функції.
Для більшості побутових завдань безплатної версії достатньо. Платна підписка стає потрібною, якщо ви регулярно займаєтеся дослідженнями, працюєте з великими файлами або ставите багато складних запитів.
Як шукати в Perplexity та правильно формулювати запити
Одна з найпоширеніших помилок — використовувати Perplexity як звичайний пошуковик і вводити два-три ключові слова.
Наприклад: «ціни на електромобілі Європа». Це може дати корисну відповідь, але запит надто широкий.
Хороший запит зазвичай містить п’ять компонентів:
- Що потрібно знайти.
- За який період.
- Яка географія або аудиторія.
- Які джерела бажані.
- У якому форматі подати результат.
Наприклад: «Проаналізуй дослідження про вплив дистанційної роботи на продуктивність працівників у 2020–2026 роках. Використовуй академічні публікації та метааналізи. Розділи результати на докази позитивного, негативного та нейтрального впливу. Для кожного висновку наведи джерело».
Такий запит набагато краще задає рамки дослідження.
Як використовувати уточнюючі питання
Одна з переваг Perplexity — можливість продовжувати діалог.
Наприклад: «Які країни Європи мають найвищу частку електромобілів?»
Після відповіді можна запитати: «Тепер залиш лише дані за 2025 рік». А потім: «Перевір ці цифри за офіційними статистичними джерелами».
І нарешті: «Знайди першоджерело для кожної цифри та покажи методологію підрахунку».
Це значно ефективніше, ніж кожного разу починати новий пошук.
У рекомендаціях самого Perplexity також радять використовувати уточнюючі питання: почати із загального питання, а потім поступово звужувати тему.
Чим звичайний пошук відрізняється від Pro Search і Research / Deep Research
У Perplexity різні режими пошуку відрізняються насамперед глибиною дослідження, кількістю пошукових кроків і складністю завдання. Простий запит не потребує такого самого обсягу роботи, як підготовка повноцінного аналітичного звіту.
Умовно режими можна розділити так: звичайний пошук → Pro Search → Research / Deep Research — чим далі праворуч, тим більше часу та ресурсів система витрачає на пошук і аналіз інформації.
Розберемо разом, коли який рівень пошуку використовувати.
| Критерій | Standard Search | Pro Search Perplexity | Research / Deep Research Perplexity |
| Для чого підходить | Прості та конкретні питання, пошук фактів, короткі пояснення | Складні питання, що потребують пошуку в кількох джерелах, порівняння та синтезу | Комплексні дослідження, огляди ринку, аналіз великої кількості джерел |
| Приклад запиту | «Яка столиця Канади?» «Коли вийшов iPhone 15?» «Що таке RAG?» | «Порівняй Naive RAG, Graph RAG та Agentic RAG. Для кожного поясни принцип роботи, переваги, недоліки та сценарії використання» | «Проведи дослідження ринку AI coding assistants у 2024–2026 роках. Проаналізуй гравців, динаміку ринку, дослідження, ціни та тренди» |
| Що робить ШІ | Швидко шукає інформацію у вебі, знаходить релевантні джерела та формує коротку відповідь із посиланнями | Виконує пошук у кількох джерелах, аналізує та зіставляє інформацію, після чого формує детальнішу відповідь | Розбиває завдання на підзапити, виконує численні пошуки, опрацьовує велику кількість матеріалів, порівнює їх і готує структурований звіт |
| Аналіз джерел | Базовий, кілька релевантних джерел | Порівняння та синтез інформації, більше джерел із різних сайтів | Глибокий аналіз і зіставлення матеріалів, велика кількість джерел |
| Результат | Коротка відповідь із кількома джерелами | Розгорнута відповідь із аналізом, порівняннями та цитатами | Повноцінний дослідницький звіт із великою кількістю джерел |
Якщо дуже коротко:
- Search — «знайди інформацію»,
- Pro Search — «знайди й проаналізуй інформацію з кількох джерел»,
- Research / Deep Research — «проведи повноцінне дослідження та підготуй звіт».
Важливо, що Research Perplexity для досліджень не означає автоматично правильнішу відповідь. Він просто дозволяє провести складніший і глибший пошук. Навіть після Deep Research важливі твердження варто перевіряти за першоджерелами.
Як шукати свіжу інформацію, статистику, офіційні і академічні джерела
Одна з головних переваг Perplexity — можливість шукати не лише за ключовими словами, а й одразу задавати вимоги до джерел, дати та способу перевірки інформації. Це особливо важливо, коли йдеться про статистику, наукові дослідження або актуальні події.
Загалом для надійного пошуку можна використовувати просту формулу: Що знайти + за який період + де шукати + які джерела пріоритетні + як перевірити результат.
Як шукати свіжу інформацію
Якщо питання стосується актуальних подій, цін, статистики або законодавства, потрібно явно вказувати дату або потрібний період.
| ❌ Поганий запит | ✅ Кращий запит | 🌟Важливий запит |
| «Чи можуть коти співати?» | «Які нові наукові дослідження про вокалізацію та комунікацію домашніх котів опубліковано у 2025–2026 роках? Наведи академічні джерела та коротко поясни основні результати». | «Чи можуть домашні коти відтворювати звуки, які можна вважати співом? Знайди актуальні наукові дослідження про вокалізацію котів, опубліковані у 2024–2026 роках. Використовуй академічні джерела, поясни, які звуки видають коти, для чого вони їх використовують і чи є докази здатності котів імітувати або відтворювати мелодійні звуки. Наведи посилання на першоджерела». |
Але навіть такий запит не гарантує, що всі знайдені матеріали справді свіжі. Дата сторінки та дата даних — не одне й те саме.
Наприклад, стаття, опублікована у 2026 році, може цитувати статистику за 2023-й. Тому завжди дивіться не лише на дату публікації сторінки, а й на період, до якого належать самі дані.
Як знаходити офіційне джерело
Якщо потрібні статистичні або нормативні дані, важливо не просто знайти сайт, який їх цитує, а дійти до організації, яка зібрала або опублікувала дані.
Наприклад: «Скільки українців користувалися генеративним AI у 2025 році? Використовуй офіційну статистику державних або міжнародних організацій. Для кожної цифри наведи першоджерело, дату публікації та період збору даних».
Такий запит допоможе відокремити первинну статистику від матеріалів медіа, блогів та аналітичних оглядів.
Якщо потрібна інформація від конкретної установи, це можна прямо зазначити в запиті:
«Знайди актуальні правила отримання візи до Канади. Використовуй лише офіційні сайти уряду Канади» або «Які вимоги GDPR стосуються використання генеративного AI? Використовуй лише офіційні документи Європейської комісії та EUR-Lex».
Це значно краще, ніж запитувати просто «які вимоги GDPR», а потім намагатися відрізнити юридичний першодокумент від переказу в блозі.
Як шукати академічне джерело
Для наукових тем можна попросити: «Знайди академічні дослідження про вплив LLM на програмування. Пріоритет: систематичні огляди, метааналізи та наукові статті, що пройшли рецензування. Для кожної роботи вкажи рік, авторів, вибірку, методологію та основний результат».
Особливо корисно просити не просто «наукові джерела», а конкретний тип доказів:
- систематичні огляди,
- метааналізи,
- рандомізовані контрольовані дослідження,
- наукові публікації, що пройшли рецензування,
- офіційні звіти дослідницьких організацій.
У Perplexity також доступні спеціалізовані джерела. Наприклад, сервіс повідомляє про інтеграцію контенту Wiley, включно з науковими журналами та професійними публікаціями.
Якщо потрібні найновіші результати: «Знайди академічні дослідження 2024–2026 років про вплив LLM на програмування. Не використовуй блоги та маркетингові матеріали. Для кожного дослідження наведи методологію, розмір вибірки та основний висновок».
Це змушує Perplexity шукати не просто згадки про наукову роботу, а самі публікації та їхні характеристики.
Як влаштовані цитати і посилання на джерела у відповідях Perplexity
Одна з ключових особливостей Perplexity — відповідь супроводжується цитатами, які ведуть до джерел, використаних під час пошуку. Perplexity позиціонує це як спосіб перевірити інформацію та перейти до оригінального матеріалу.
У тексті відповіді цитати зазвичай прив’язані до конкретних тверджень. Наприклад: «У 2025 році світові витрати на генеративний AI зросли… [1]»
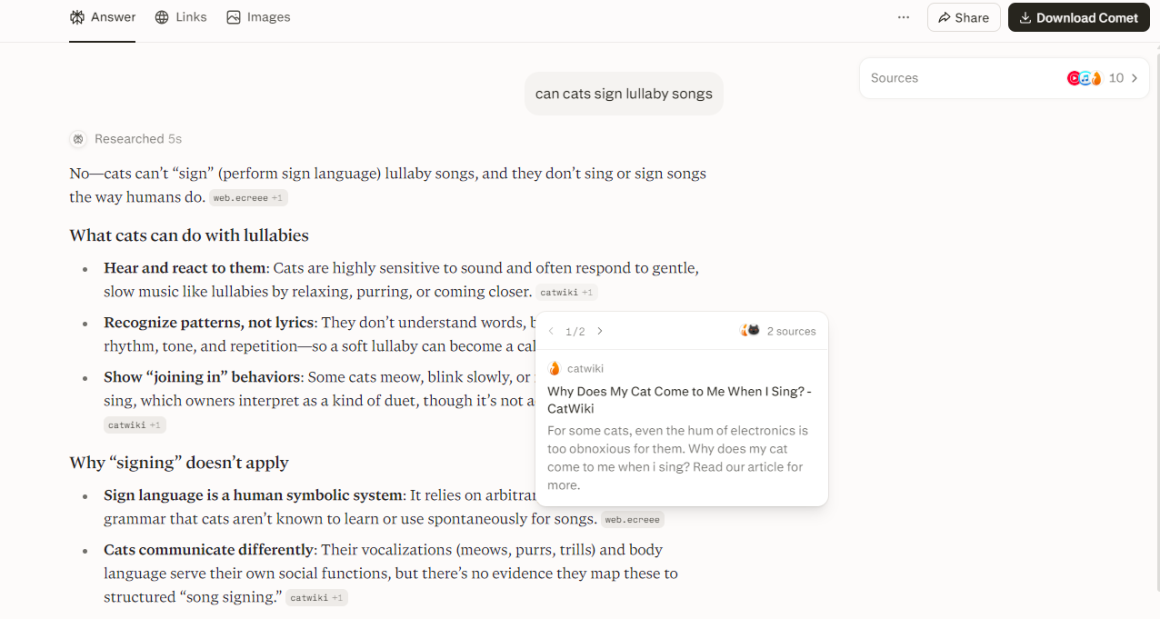
Це принципово відрізняється від звичайного чатбота, який може просто видати твердження без посилання на матеріал, на якому воно грунтується.
Але цитата не означає, що твердження автоматично правильне — це найважливіше правило.
Наявність посилання на джерела Perplexity показує, що нейромережа використала цей матеріал у процесі формування відповіді, але не гарантує, що джерело справді підтверджує сформульоване AI твердження.
Наприклад, Perplexity може написати: «Дослідження показало, що використання AI підвищує продуктивність програмістів на 30%».
І додати посилання на наукову статтю. Але після відкриття статті може виявитися, що:
- 30% — це результат лише для певної групи учасників,
- дослідження вимірювало інший показник,
- цифра стосується конкретного експериментального сценарію,
- автори говорять про кореляцію, а не причинний зв’язок,
- або 30% — це взагалі результат, який наводиться в іншій частині роботи.
Тому перевіряти потрібно не лише наявність цитати, а відповідність між твердженням і джерелом.
Для простого факту достатньо відкрити цитоване джерело. Для важливої статистики, наукового висновку або твердження, яке ви плануєте використати у статті, краще пройти весь ланцюжок:
твердження → цитата Perplexity → оригінальна сторінка → конкретний фрагмент → контекст → незалежне підтвердження.
Саме тому наявність великої кількості посилань не повинна створювати ілюзію абсолютної достовірності. Perplexity добре показує, звідки взялася інформація, але відповідальність за перевірку того, чи справді джерело підтверджує конкретне твердження, залишається на користувачеві.
Як правильно перевіряти цитату
Ось простий алгоритм, як перевірити відповідь Perplexity для важливого твердження:
| Крок | Що робити | На що звернути увагу |
| Знайдіть конкретне твердження | Не намагайтеся перевірити всю відповідь одночасно. Виберіть окрему тезу, яку можна перевірити | Оберіть твердження, наприклад, «X збільшує продуктивність на 40%» |
| Відкрийте цитоване джерело | Перейдіть безпосередньо до сторінки або документа, на який посилається Perplexity. Не обмежуйтеся заголовком чи коротким описом | Відкрийте оригінальну статтю, звіт, дослідження або документ |
| Знайдіть фрагмент, на який спирається твердження | Знайдіть у джерелі конкретну цифру, тезу або формулювання, яке підтверджує твердження | Пошукайте ключові слова, цифри або відповідний фрагмент тексту |
| Перевірте контекст | З’ясуйте, за яких умов отримано результат і чи не зробив Perplexity ширший висновок, ніж дозволяють дані | У джерелі може бути: «У нашій вибірці певна група учасників показала на 40% кращий результат за конкретним показником». Це не те саме, що «AI загалом підвищує продуктивність на 40%» |
| Перевірте першоджерело | Якщо Perplexity посилається на вторинний матеріал, знайдіть оригінальне дослідження або документ | Новина → дослідження → першоджерело. Чим важливіше твердження, тим ближче до першоджерела його варто перевіряти |
Наприклад, після відповіді можна поставити уточнювальний запит: «Для кожного ключового твердження покажи джерело, яке безпосередньо його підтверджує. Якщо джерело підтверджує лише частину твердження, зазнач це окремо».
Що означають Government, Academic і Trusted
У Perplexity деякі джерела можуть мати спеціальні позначки:
| Мітка | Що означає | Приклади джерел | На що звернути увагу |
| Government | Офіційний урядовий або державний ресурс | Державні відомства, міністерства, статистичні служби, офіційні урядові портали | Перевіряйте дату, актуальність даних і те, чи справді документ стосується вашого питання |
| Academic | Академічне або наукове джерело | Наукові журнали, університетські репозитарії, дослідницькі публікації | Важливо перевірити авторів, методологію, вибірку, дату та чи пройшла публікація рецензування |
| Trusted | Джерело, яке Perplexity класифікує як надійне для певного типу інформації | Авторитетні медіа, професійні ресурси, відомі організації та спеціалізовані сайти | Це не означає, що конкретне твердження на сторінці є достовірним або незалежно підтвердженим |
Вони характеризують домен загалом, а не конкретну сторінку. Наприклад, Government означає офіційний урядовий сайт, Academic — науковий ресурс, а Trusted — сайт, який Perplexity віднесла до надійних у певній галузі.
Також ці позначки не є гарантією істинності конкретного твердження. Навіть сторінка на урядовому чи академічному сайті може містити застарілі дані, стосуватися іншого контексту або просто не підтверджувати висновок, який зробив Perplexity. Тобто мітка не замінює самостійної перевірки джерела.
Як перевіряти джерела в perplexity
Навіть якщо пошуковик Perplexity знайшов першоджерело, його не варто автоматично вважати достовірним. Першоджерело — це не синонім якісного джерела. Воно лише означає, що інформація походить безпосередньо від автора, організації або дослідників, які її створили чи зібрали.
Для швидкої оцінки можна перевірити п’ять основних критеріїв:
| Критерій | Що перевірити | Приклад запитання |
| Автор | Хто підготував матеріал? Яка його експертиза та організація? | «Хто автор дослідження і чи має він відповідну експертизу?» |
| Дата | Коли опубліковано матеріал і за який період наведено дані? | «Це актуальні дані чи застаріла інформація?» |
| Контекст | За яких умов отримано результат? На кого він поширюється? | «Чи можна поширювати цей висновок на всіх користувачів, якщо досліджували лише одну групу?» |
| Методологія | Як отримано дані, яка вибірка, метод вимірювання та обмеження дослідження? | «Як саме автори отримали цю цифру і які є обмеження?» |
| Репутація | Яка репутація автора або організації? Чи є незалежне підтвердження результатів? | «Наскільки автору або організації можна довіряти? Чи підтверджують їхні висновки незалежні джерела?» |
Автор
Спочатку потрібно з’ясувати, хто саме стоїть за інформацією. Для академічного дослідження це можуть бути конкретні науковці та університет або дослідницька установа.
Для статистики — державне відомство чи міжнародна організація. Для комерційного звіту — аналітична компанія.
Водночас відомий автор або організація не гарантують правильності конкретного твердження. Репутація — це лише один із критеріїв.
Дата
Перевіряйте не тільки дату публікації, а й дату самих даних. Наприклад, звіт, опублікований у 2026 році, може аналізувати статистику за 2024-й. Для швидкозмінних тем — технологій, цін, ринків, законодавства — ця різниця особливо важлива.
Контекст
Цифру або висновок не можна виривати з контексту. Наприклад: «AI підвищив продуктивність на 40%».
Після перевірки може виявитися, що дослідники вимірювали лише один показник, експеримент проводився на невеликій групі учасників, а результат стосувався конкретного завдання.
Тому запитання має бути не лише «Чи є в джерелі ця цифра?», а й «Що саме вона означає?»
Методологія
Особливо важлива для статистики та наукових досліджень. Варто перевірити:
- як збирали дані,
- який розмір і склад вибірки,
- що саме вимірювали,
- як розраховували показник,
- чи була контрольна група,
- які обмеження визнають автори.
Чим складніше твердження, тим важливіше розуміти, як саме було отримано результат.
Репутація та незалежне підтвердження
Навіть якісне першоджерело краще не залишати без перевірки, якщо твердження важливе. Спробуйте знайти інші незалежні дослідження або джерела, які підтверджують результат.
Особливо це важливо для:
- прогнозів,
- оцінок ринку,
- статистики,
- медичних тверджень,
- наукових висновків,
- гучних або неочікуваних заяв.
Простий тест для першоджерела
Перед використанням інформації можна поставити собі п’ять запитань:
- Хто це сказав?
- Коли це було опубліковано?
- У якому контексті?
- Як це було доведено або виміряно?
- Чи підтверджують це інші незалежні джерела?
Якщо на всі п’ять питань є зрозуміла відповідь, джерело має значно більше підстав для довіри.
Як знаходити декілька незалежних підтверджень і порівнювати суперечливі джерела
Якщо важливе твердження підтверджує лише одне джерело, цього може бути недостатньо. Особливо обережно варто працювати зі статистикою, прогнозами, результатами досліджень та гучними заявами. У таких випадках Perplexity можна використовувати не для пошуку «правильної» відповіді, а для порівняння різних незалежних свідчень.
Для надійного фактчекінгу корисна така послідовність:
конкретне твердження → кілька незалежних джерел → перевірка першоджерел → порівняння методологій → пошук суперечливих результатів → пояснення розбіжностей → обережний висновок.
1. Сформулюйте конкретне твердження
Не варто запитувати: «Чи правда, що AI підвищує продуктивність?»
Краще виділити конкретну тезу: «Чи підвищує використання AI продуктивність програмістів приблизно на 30%?»
Чим конкретніше твердження, тим простіше перевірити, що саме підтверджують джерела.
2. Попросіть знайти незалежні джерела
У Perplexity можна сформулювати запит так: «Знайди щонайменше п’ять незалежних досліджень, які перевіряють вплив AI на продуктивність програмістів. Для кожного вкажи авторів, рік, методологію, вибірку та основний результат. Не використовуй статті, які просто переказують одне й те саме дослідження».
Важливо саме слово «незалежні». П’ять статей не є п’ятьма підтвердженнями, якщо всі вони посилаються на одне першоджерело.
3. Перевірте, чи справді джерела незалежні
Два джерела можуть виглядати різними, але використовувати ті самі дані.
Наприклад: Дослідження A → новина → аналітичний звіт → блог.
Формально це чотири джерела, але фактично — одне первинне дослідження.
Тому корисно попросити: «Перевір, чи є ці джерела незалежними одне від одного. Вкажи, які з них використовують власні дані, а які цитують або переказують інші дослідження».
4. Не намагайтеся одразу знайти «правильну» цифру
Якщо джерела суперечать одне одному, це не означає, що одне з них обов’язково помиляється.
Наприклад:
| Джерело | Результат | Методологія |
| Дослідження A | +30% | Лабораторний експеримент |
| Дослідження B | +12% | Реальні робочі процеси |
| Дослідження С | −5% | Інша група користувачів |
Замість запиту «Яка цифра правильна?» краще запитати: «Чому результати цих трьох досліджень відрізняються? Порівняй їхню вибірку, методологію, умови експерименту та спосіб вимірювання продуктивності».
Так можна виявити, що дослідження насправді відповідають на різні питання.
5. Порівняйте джерела за однаковими критеріями
Для суперечливих джерел зручно попросити Perplexity створити таблицю: «Порівняй ці дослідження за авторами, датою, розміром вибірки, методологією, показником, який вимірювався, результатом та основними обмеженнями».
Це дозволяє побачити, де саме виникає розбіжність.
Наприклад, один звіт може вимірювати швидкість виконання завдання, а інший — якість кінцевого результату. Обидва можуть бути коректними, але їхні результати не можна безпосередньо порівнювати.
6. Шукайте джерела, які спростовують початкову тезу
Це особливо корисний прийом. Наприклад: «Знайди якісні дослідження, результати яких суперечать твердженню, що AI підвищує продуктивність програмістів на 30%. Поясни, чому вони отримали інші результати».
Так ви зменшуєте ризик confirmation bias (підтверджувального упередження) — ситуації, коли користувач або система шукає переважно інформацію, що підтверджує вже сформовану думку.
7. Попросіть Perplexity пояснити суперечність
Хороший запит: «У мене є дві суперечливі оцінки ринку генеративного AI: $30 млрд і $600 млрд. Знайди першоджерела обох оцінок. Порівняй визначення ринку, методологію, період оцінки та категорії витрат. Поясни, чи справді ці цифри суперечать одна одній».
У багатьох випадках виявиться, що суперечність лише позірна: різні дослідники рахували різні сегменти або використовували різні визначення терміна.
Головний принцип при суперечливих даних: не варто запитувати Perplexity «Яке джерело правильне?», краще запитати: «Чому ці джерела дають різні результати?»
Це змінює сам підхід до пошуку. Замість того щоб змушувати AI вибрати одну цифру, ви отримуєте можливість розібрати методологію, контекст і якість доказів.
Чому Perplexity може помилятися навіть із посиланнями
Наявність посилань у відповіді Perplexity не гарантує, що сама відповідь правильна. Система може знайти реальні джерела, але неправильно інтерпретувати їхній зміст, перебільшити висновок або приписати джерелу твердження, якого в ньому насправді немає.
Є кілька типових причин:
- Неправильна інтерпретація джерела. Perplexity може коректно знайти статтю, але неправильно зрозуміти її висновки або перенести результат із конкретної групи людей на всіх.
- Виривання інформації з контексту. Наприклад, у дослідженні може йтися про підвищення продуктивності на 30% за певних умов, а у відповіді це перетворюється на твердження, що технологія загалом підвищує продуктивність на 30%.
- Застаріле джерело. Посилання може бути справжнім, але інформація вже не актуальна. Особливо це важливо для цін, статистики, законодавства, технологій та ринкових показників.
- Вторинне джерело. Perplexity може послатися на новину, блог або аналітичну статтю, яка переказує дослідження. При цьому помилка могла виникнути ще на етапі такого переказу.
- Неправильне узагальнення. Джерело може підтверджувати лише конкретний факт, тоді як Perplexity робить із нього ширший висновок.
- Помилка в цифрах або датах. Навіть якщо посилання веде на реальний звіт, модель може переплутати показники, роки, одиниці вимірювання або прогноз із фактичними даними.
Тому корисно розрізняти дві речі: «Perplexity має посилання» і «посилання підтверджує твердження Perplexity» — це не одне й те саме.
Наприклад, якщо Perplexity пише «Дослідження показало, що AI підвищує продуктивність програмістів на 40%» і додає посилання, варто перевірити саме дослідження: кого досліджували, що саме вимірювали, за яких умов отримали 40% і чи справді автори роблять такий висновок.
Тому для важливих фактів найнадійніший алгоритм залишається простим:
твердження → цитата Perplexity → першоджерело → конкретний фрагмент → контекст → незалежне підтвердження.
Іншими словами, посилання — це не доказ істинності, а точка входу, де починається перевірка фактів Perplexity.
Як користуватись Perplexity для фактчекінгу, навчання, дослідження і пошуку технічної інформації
Perplexity найкраще використовувати не просто як «чат із відповідями», а як дослідницький пошуковик із цитатами. Perplexity шукає в інтернеті у реальному часі й показує джерела, які можна перевірити.
Ось практична шпаргалка, яку можна буквально копіювати в Perplexity:
| Завдання | Як діяти | Готовий промпт | Що перевіряти |
| Фактчекінг | Дай твердження і попроси знайти докази за і проти | Перевір твердження: “[твердження]”. Знайди першоджерела, докази за і проти, незалежні підтвердження та спростування. Вкажи дату й рівень надійності кожного джерела | Чи є першоджерело, чи підтверджують його незалежні джерела |
| Перевірка новини | Шукай не одну статтю, а кілька незалежних джерел | Перевір цю новину: “[текст/посилання]”. Визнач, що є фактом, що інтерпретацією, а що не підтверджено. Знайди першоджерело | Дата, першоджерело, контекст, цитати |
| Вивчення теми з нуля | Попроси побудувати навчальний маршрут | Навчи мене [тема] з нуля до просунутого рівня. Побудуй програму з 10 кроків, пояснюй кожен простими словами, після кожного кроку дай 3 питання для перевірки | Чи є джерела й практичні завдання |
| Глибоке розуміння | Проси пояснення на кількох рівнях | Поясни [тема] спочатку як дитині, потім на рівні студента, потім на професійному рівні. Покажи аналогії, приклади та типові помилки | Чи не спрощує модель важливі нюанси |
| Наукове дослідження | Проси academic papers + першоджерела | Досліди [тема] за науковими публікаціями. Знайди ключові дослідження, метааналізи та огляди. Порівняй результати й вкажи, де є науковий консенсус, а де суперечки | Рік, журнал, методологія, кількість досліджень |
| Порівняння технологій | Задай однакові критерії | Порівняй [A], [B] і [C] за ціною, продуктивністю, безпекою, масштабованістю, простотою використання та підтримкою. Використовуй актуальні джерела | Чи однакові критерії застосовані до всіх |
| Програмування | Проси актуальну офіційну документацію | Як реалізувати [задача] у [технологія]? Використовуй актуальну офіційну документацію. Вкажи версію, API, приклад коду та типові помилки | Версію документації та дату |
| Debugging | Дай код + помилку + контекст | Ось код: [код]. Помилка: [error]. Знайди причину, поясни її та запропонуй 2-3 способи виправлення. Посилайся на офіційну документацію | Чи відтворюється причина на актуальній версії |
| Документація | Проси витягнути конкретну інформацію | Проаналізуй документацію [технологія]. Знайди, як працює [функція]. Дай коротке пояснення, приклад використання, обмеження та посилання на відповідний розділ | Чи веде посилання саме на документацію |
| Дискусійне питання | Проси аргументи обох сторін | Досліди питання “[тема]”. Наведи найсильніші аргументи “за” і “проти”, докази для кожного та зроби висновок лише на основі доказів | Чи не підбирає джерела лише під одну позицію |
| Аналіз даних | Проси джерело кожної цифри | Знайди актуальні дані про [тема]. Створи таблицю: показник, значення, рік, джерело. Не використовуй цифри без перевіреного джерела | Рік, методику збору, оригінальне джерело |
| Дослідження компанії | Поєднуй офіційні та незалежні джерела | Проведи дослідження [компанія]. Проаналізуй бізнес-модель, фінанси, продукти, конкурентів, ризики та останні новини. Відокрем факти від оцінок | Офіційні звіти + незалежні джерела |
| Вибір продукту | Спочатку критерії, потім рекомендація | Порівняй [продукти]. Мої критерії: [критерії]. Знайди актуальні характеристики, ціни та відгуки. В кінці дай рекомендацію для мого сценарію | Дата цін/характеристик, незалежні огляди |
| Актуальна інформація | Обов’язково проси перевірити дату | Знайди найактуальнішу інформацію про [тема] станом на сьогодні. Пріоритет — джерела за останні [X] днів/місяців | Дата публікації |
| Синтез інформації | Дай кілька джерел і попроси об’єднати | Проаналізуй ці джерела: [посилання]. Знайди спільні висновки, суперечності та інформацію, якої бракує. Не додавай тверджень без джерел | Чи справді висновок випливає з джерел |
Які помилки частіше за все допускають при роботі з Perplexity
Найчастіша проблема — люди сприймають Perplexity як готового експерта, а не як інструмент дослідження. Сам Perplexity рекомендує чітко задавати мету, контекст, потрібний формат і потім уточнювати запит; також він прямо радить перевіряти оригінальні джерела.
| ❌ Помилка | Що відбувається | ✅ Як краще |
| Вірити відповіді без перевірки | Відповідь може звучати переконливо, але містити помилку | Відкрийте ключові цитати й перевір першоджерело |
| Вважати цитату доказом | Наявність посилання не означає, що воно підтверджує саме це твердження | Перевірте, що саме написано в джерелі |
| Питати занадто загально | «Розкажи про AI» — поверхнева відповідь | «Порівняй 5 способів використання AI в освіті у 2026 році…» |
| Не вказувати контекст | Perplexity не знає, для кого й навіщо потрібна інформація | Вказуйте: рівень знань, мету, країну, період, обмеження |
| Задавати 5 різних завдань одночасно | Результат стає поверхневим і хаотичним | Розбивайте дослідження на етапи |
| Використовувати звичайний Search для складного дослідження | Отримуєте швидку, але недостатньо глибоку відповідь | Для складних питань використовуйте Pro Search / Deep Research |
| Не просити першоджерела | У результаті можуть переважати статті, блоги або перекази | Пишіть: «Пріоритет — першоджерела, офіційна документація та академічні публікації» |
| Дивитися тільки на «Trusted/Academic» | Можна помилково сприйняти label як гарантію істинності | Label характеризує сайт загалом, а не гарантує правильність конкретної статті |
| Не перевіряти дату | Отримуєте застарілу інформацію, особливо про технології | Пишіть: «Використовуй інформацію станом на 2026 рік» |
| Не перевіряти версію технології | Код може працювати для старої версії API | Завжди вказуйте версію: Python 3.13, React 19, API v2 тощо |
| Просити одразу висновок | ШІ-асистент може швидко підтвердити вашу початкову гіпотезу | Спочатку: «Знайди аргументи за і проти та суперечливі дані» |
| Підтверджувати власну думку | Виникає confirmation bias | Просіть Perplexity спростувати власну гіпотезу |
| Не розділяти факт і висновок | Інтерпретація може виглядати як встановлений факт | Попросіть розділити факти, інтерпретації та припущення |
| Не задавати формат результату | Отримуєте довгий текст замість того, що потрібно | Попросіть таблицю, список, timeline, порівняння тощо |
| Зупинятися після першої відповіді | Найкраща інформація часто з’являється після уточнення | Використовуйте ланцюжок: знайди → перевір → порівняй → зроби висновок |
Бонус: практичний розбір дослідження на прикладах
Хочемо показати вам, як працювати дослідженнями Perplexity на конкретних прикладах.
Приклад 1: Жартівливе дослідження про спів котів
На перший погляд, запит «Чи можуть коти співати?» здається елементарним. Але якщо поставити завдання як дослідницьке, Perplexity має уточнити, що саме ми називаємо «співом», знайти наукові джерела, порівняти різні пояснення та перевірити першоджерела.
Ось як можна розкласти такий запит на кроки.
1. Визначте, що саме означає «співати»
Запит «Чи можуть коти співати?» насправді неоднозначний.
«Співати» може означати:
- відтворювати мелодію,
- видавати звуки з певною висотою тону,
- повторювати послідовність звуків,
- імітувати людський спів,
- використовувати вокалізацію для комунікації,
- просто видавати звуки, які людині нагадують спів.
Тому перший крок: «Визнач, що в науковому контексті можна вважати співом, і чи відповідає вокалізація домашніх котів цьому визначенню».
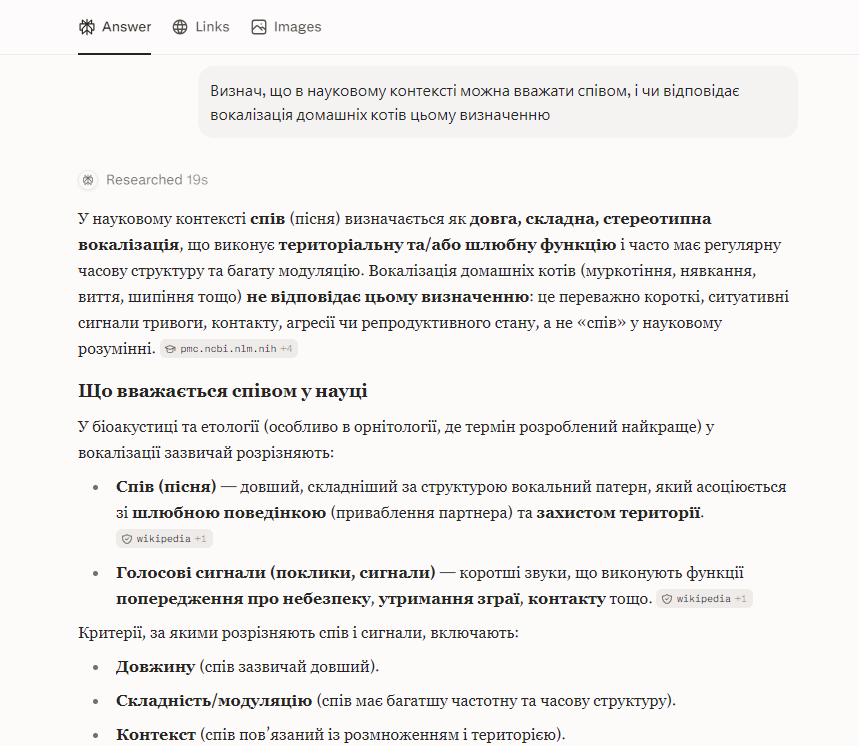
Це важливий принцип роботи з інформацією: перш ніж шукати відповідь, потрібно визначити терміни.
2. З’ясуйте, які звуки взагалі видають коти
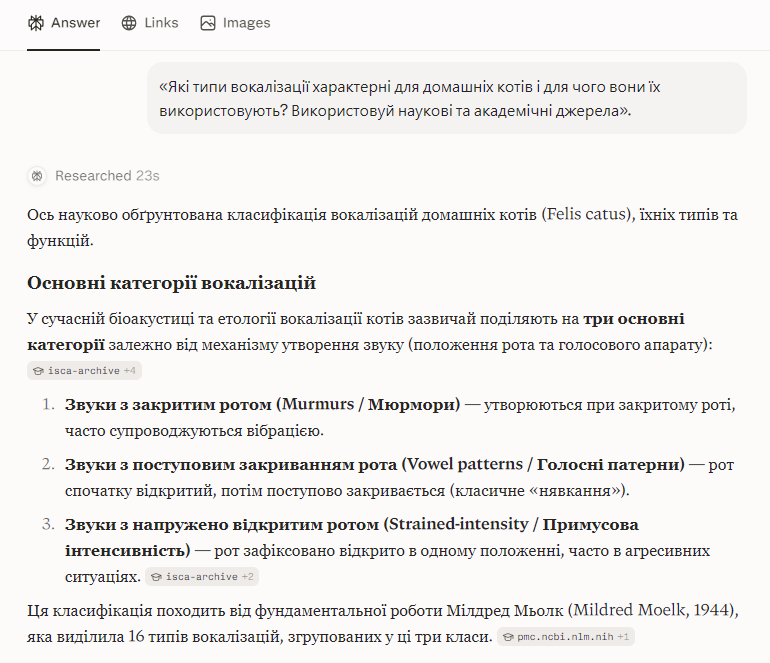
Наступний запит: «Які типи вокалізації характерні для домашніх котів і для чого вони їх використовують? Використовуй наукові та академічні джерела».
Perplexity може шукати інформацію про:
- нявкання,
- муркотіння,
- шипіння,
- гарчання,
- виття,
- трелі та інші вокалізації.
Тут питання вже змінюється з жартівливого «Чи співають коти?» на цілком наукове: «Які властивості має вокальна комунікація котів?»
3. Знайдіть академічні дослідження
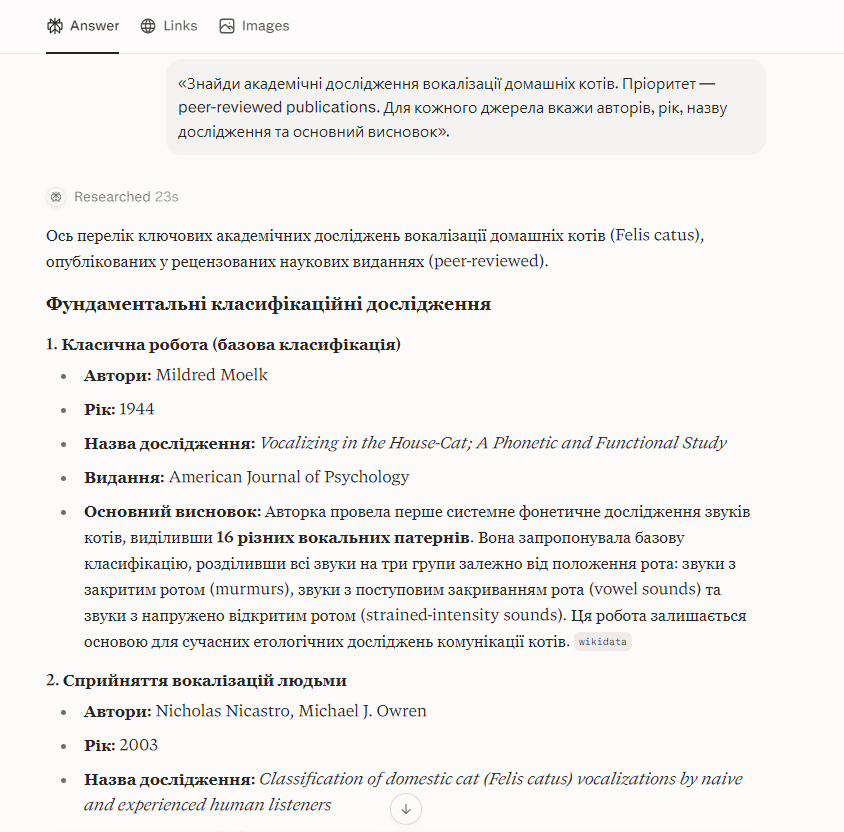
Далі можна попросити: «Знайди академічні дослідження вокалізації домашніх котів. Пріоритет — peer-reviewed publications. Для кожного джерела вкажи авторів, рік, назву дослідження та основний висновок».
Це дозволяє перейти від загальних статей в інтернеті до наукових публікацій.
І тут уже можна перевірити, що саме дослідники реально встановили, а не що про котів пишуть популярні сайти
4. Перевірте, чи є в котів «музичні» здібності
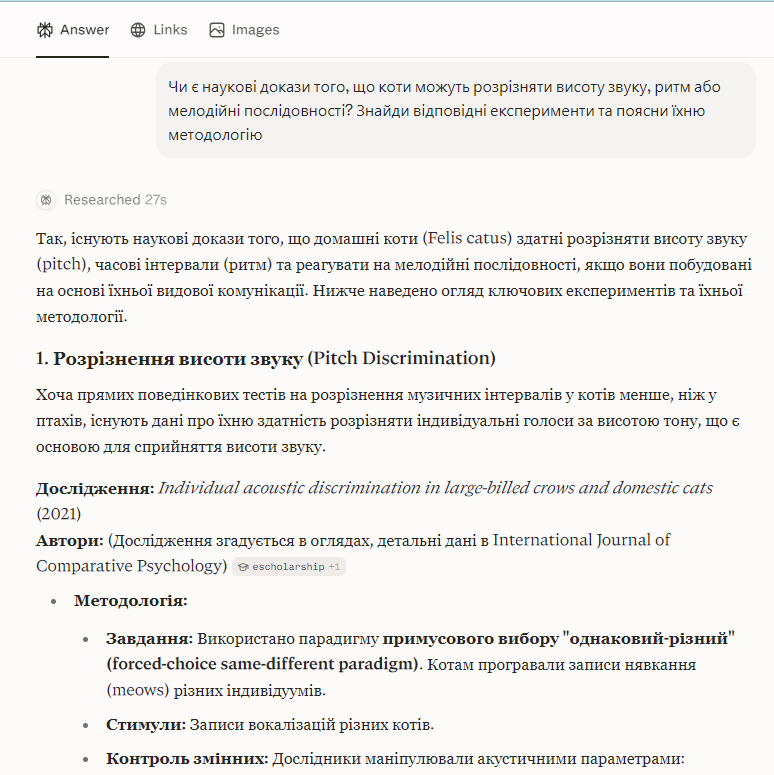
Наступний крок: «Чи є наукові докази того, що коти можуть розрізняти висоту звуку, ритм або мелодійні послідовності? Знайди відповідні експерименти та поясни їхню методологію».
Це важливе уточнення, адже здатність видавати звуки певної висоти ще не означає здатність співати в людському розумінні цього слова.
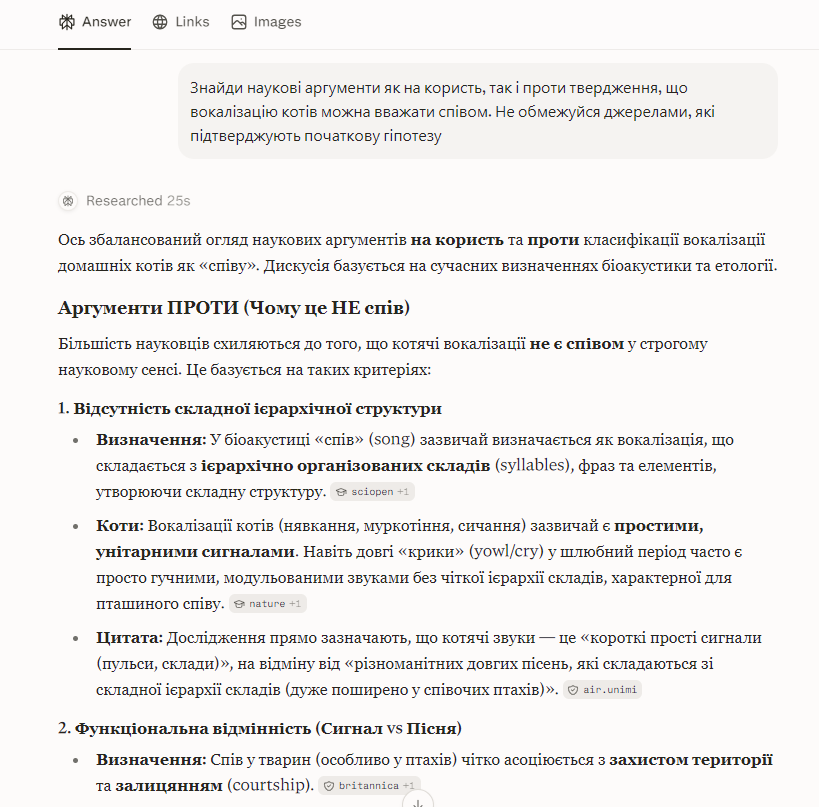
5. Знайдіть протилежні аргументи
Для якісного дослідження варто спеціально попросити систему не підтверджувати нашу гіпотезу: «Знайди наукові аргументи як на користь, так і проти твердження, що вокалізацію котів можна вважати співом. Не обмежуйся джерелами, які підтверджують початкову гіпотезу».
Це допомагає уникнути confirmation bias — ситуації, коли ми шукаємо тільки інформацію, яка підтверджує нашу початкову думку.
6. Перевірте популярні твердження
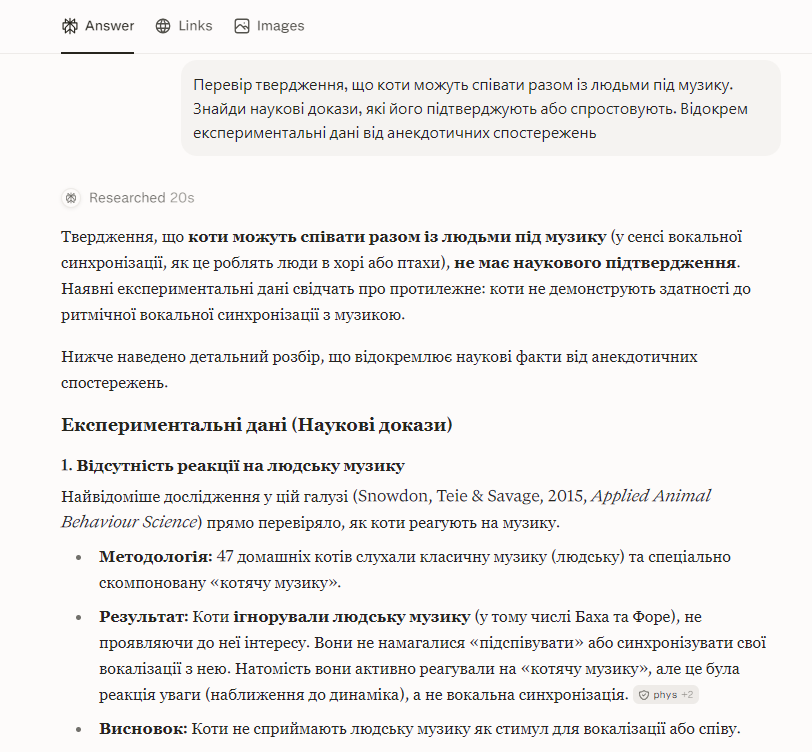
Тепер можна взяти типове твердження з інтернету: «Коти співають разом із людьми, коли чують музику».
І попросити: «Перевір твердження, що коти можуть співати разом із людьми під музику. Знайди наукові докази, які його підтверджують або спростовують. Відокрем експериментальні дані від анекдотичних спостережень».
Тут уже проявляється головна перевага AI-пошуку для фактчекінгу: він може допомогти перейти від популярного твердження до доказів.
7. Перевірте першоджерела
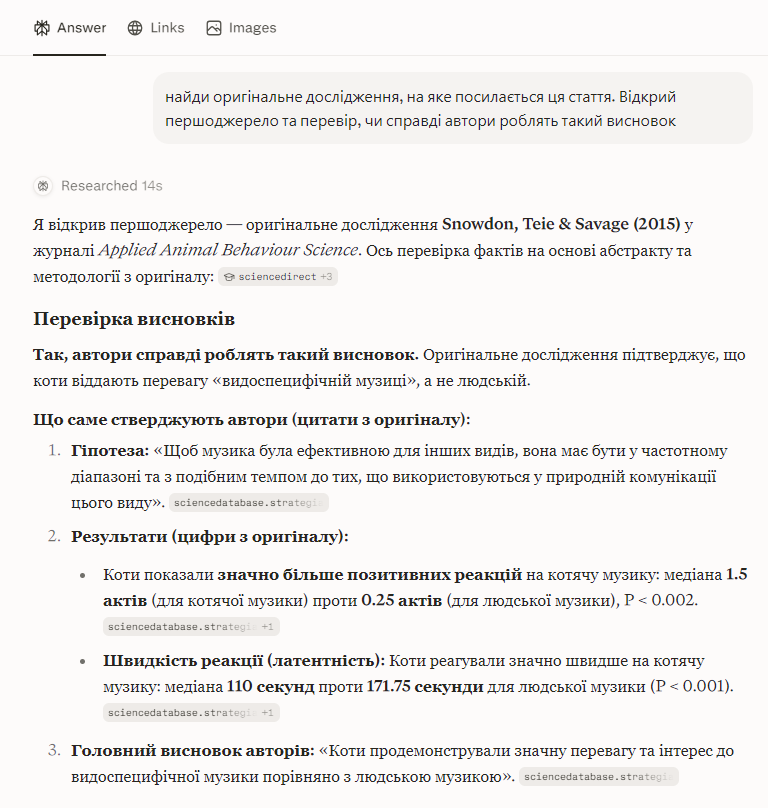
Якщо Perplexity посилається на статтю «Вчені довели, що коти люблять співати під музику», не варто автоматично цьому довіряти.
Наступний запит: «Знайди оригінальне дослідження, на яке посилається ця стаття. Відкрий першоджерело та перевір, чи справді автори роблять такий висновок».
Можливо, оригінальне дослідження насправді говорило зовсім про інше — наприклад, про реакцію котів на певні частоти або види звуків.
8. Перевірте методологію
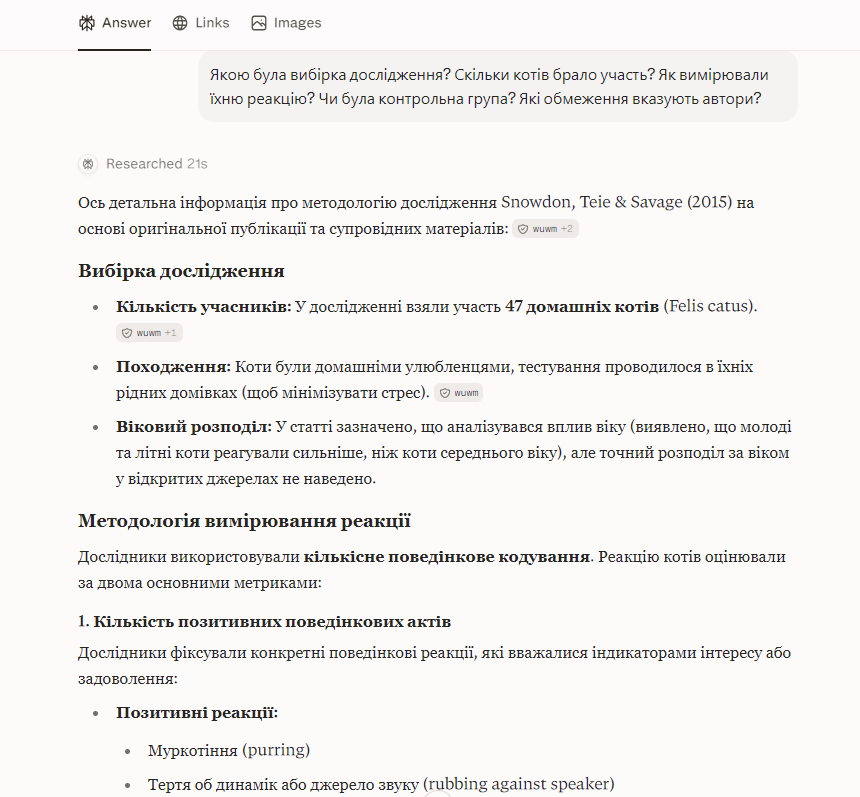
Якщо знайдено експеримент, можна поставити ще одне питання: «Якою була вибірка дослідження? Скільки котів брало участь? Як вимірювали їхню реакцію? Чи була контрольна група? Які обмеження вказують автори?»
Це вже наближає роботу Perplexity до справжнього дослідницького процесу. Адже твердження «Дослідники встановили, що коти реагують на музику» і твердження «Дослідники довели, що коти вміють співати» — це два абсолютно різні висновки.
9. Знайдіть незалежні підтвердження
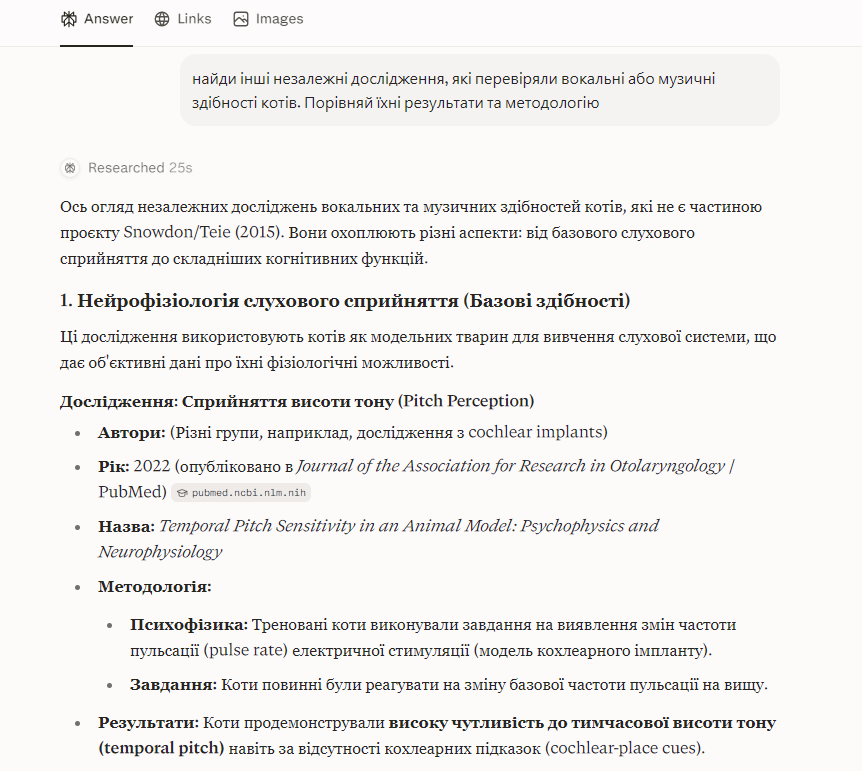
Після цього можна запитати: «Знайди інші незалежні дослідження, які перевіряли вокальні або музичні здібності котів. Порівняй їхні результати та методологію».
Якщо кілька незалежних досліджень дають схожий результат, довіра до висновку зростає.
Якщо результати суперечливі — це теж важливий результат, і Perplexity має його показати.
Фінальний результат
Після всіх цих кроків відповідь уже може виглядати приблизно так:
«У буквальному людському розумінні коти не співають: немає переконливих доказів, що вони здатні свідомо відтворювати мелодію так, як це робить людина. Водночас коти мають складну систему вокалізації та здатні контролювати характеристики своїх звуків. Тому окремі котячі вокалізації можуть звучати для людини як спів, але це не означає, що тварина виконує мелодію в людському розумінні».
І тут головне не сама відповідь про котів. Важливий ланцюжок роботи:
жартівливе питання → уточнення термінів → пошук наукових джерел → перевірка експериментів → аналіз методології → пошук альтернативних пояснень → перевірка першоджерел → висновок
Саме на такому простому прикладі добре видно, чим Research відрізняється від звичайного пошуку. Search просто відповість на «Чи можуть коти співати?», тоді як Research може перетворити це питання на маленьке дослідження — і, що важливіше, показати, на чому ґрунтується отриманий висновок.
Приклад 2: Серйозне дослідження про ринок генеративного AI
Розберемо кроки за запитом «Яким був світовий ринок генеративного AI у 2025 році? Наведи оцінки щонайменше трьох незалежних дослідницьких організацій, вкажи методологію та посилання на першоджерела».
Використовуючи цей запит, ми покажемо, як саме Perplexity має розкладати складне дослідницьке завдання на окремі кроки. Причому тут є важлива пастка: різні дослідницькі організації можуть рахувати різні речі під назвою «ринок генеративного AI», тому просто зібрати три цифри недостатньо.
1. Спочатку визначити, що саме означає «ринок»
Запит «Яким був світовий ринок генеративного AI у 2025 році?» насправді неоднозначний.
«Ринок» може означати:
- виручку від GenAI-програмного забезпечення,
- витрати компаній на GenAI,
- витрати на моделі та API,
- enterprise GenAI,
- GenAI разом із hardware та IT services,
- усю економічну цінність, яку створює технологія.
Наприклад, Gartner у прогнозі на 2025 рік оцінював світові витрати на GenAI у $644 млрд, причому до цього показника входять hardware, software та IT services. Gartner прямо зазначає, що оцінка базується на аналізі продажів понад 1000 постачальників із використанням первинних і вторинних досліджень.
А Grand View Research оцінює розмір самого generative AI market у $22,2 млрд у 2025 році. Це вже інша категорія та інша методологія.
Тобто перший крок Perplexity мав би бути:
«Визнач, як кожна дослідницька організація визначає generative AI market і що саме входить у її оцінку».
Без цього порівнювати цифри некоректно.
2. Знайти щонайменше три незалежні оцінки
Наступний крок: «Знайди щонайменше три незалежні дослідницькі організації, які оцінюють світовий ринок або витрати на генеративний AI у 2025 році».
Наприклад, можна отримати такі результати:
| Організація | Оцінка на 2025 рік | Що саме рахується |
| Gartner | $644 млрд | сукупні GenAI spending: hardware, software, IT services |
| Grand View Research | $22,2 млрд | generative AI market |
| MarketsandMarkets | $32,2 млрд | generative AI market |
| Menlo Ventures | $37 млрд | enterprise generative AI spending |
MarketsandMarkets оцінює глобальний generative AI market у $32,2 млрд у 2025 році, порівняно з $20,9 млрд у 2024-му.
Menlo Ventures використовує інший підхід: за їхньою оцінкою, компанії витратили $37 млрд на generative AI у 2025 році, з яких $19 млрд припало на application layer. Дослідники поєднали опитування близько 500 американських корпоративних decision-makers із bottom-up моделлю ринку, яка охоплює model APIs, infrastructure та applications.
Уже тут видно, чому не можна просто написати: «За даними різних дослідників, ринок GenAI у 2025 році становив від $22 до $644 млрд».
Це буде оманливе порівняння різних показників.
3. Знайти першоджерело для кожної цифри
Наступний запит до Perplexity: «Для кожної оцінки знайди оригінальний звіт або пресреліз дослідницької організації. Не використовуй новинні статті та агрегатори як джерело цифри».
Це важливо, тому що можна натрапити на статтю на сайті медіа, де написано: «За даними Gartner, ринок GenAI становитиме $644 млрд».
Але краще перейти безпосередньо до Gartner і подивитися, що саме означає ця цифра.
У першоджерелі Gartner прямо зазначено, що $644 млрд — це worldwide GenAI spending, а не просто «дохід ринку GenAI».
4. З’ясувати методологію для кожного джерела
Тут починається найважливіша частина.
Запит: «Для кожної організації опиши методологію оцінки: які категорії враховуються, які дані використовуються, чи це фактичні витрати, оцінка ринку або прогноз, і який часовий період охоплює дослідження».
Наприклад:
- Gartner — методологія базується на аналізі продажів понад 1000 постачальників у різних категоріях GenAI, із використанням primary та secondary research.
- Menlo Ventures — компанія поєднує опитування приблизно 500 корпоративних осіб, які ухвалюють рішення, що охоплює моделі, інфраструктуру та прикладні AI-рішення.
- Grand View Research — використовує власні технологічні бази даних, інтерв’ю з керівниками та regulatory analysis; звіт проходить внутрішній peer review.
Тепер ми вже порівнюємо не просто цифри, а способи їх отримання.
5. Перевірити, чи це прогноз чи фактична оцінка
Це ще одна важлива деталь.
Наприклад, Gartner у березні 2025 року прогнозував $644 млрд витрат на GenAI у 2025 році. А Grand View Research у пізнішому дослідженні вже наводить $22,2 млрд як оцінений market size за 2025 рік.
Тобто це не обов’язково порівняння: прогноз vs прогноз. Одна цифра може бути вказана до завершення 2025 року, а інша — ретроспективною оцінкою після завершення року.
У хорошому дослідженні Perplexity має це зазначити.
6. Знайти причину величезної різниці
Після збору цифр варто поставити окремий запит: «Чому Gartner оцінює GenAI spending у $644 млрд, тоді як Grand View Research оцінює generative AI market у $22,2 млрд? Чи можна ці показники безпосередньо порівнювати?»
І відповідь тут, найімовірніше, буде «ні».
Gartner включає значно ширший набір витрат — зокрема hardware, software та IT services. Grand View Research описує окремий generative AI market із компонентами software і services та іншою структурою сегментації.
Тобто різниця майже у 30 разів не означає, що один із дослідників обов’язково помиляється.
Вони можуть рахувати різні ринки.
7. Попросити Perplexity знайти суперечливі оцінки
Це дуже корисний крок для дослідження: «Знайди дослідницькі організації, чиї оцінки 2025 generative AI market істотно відрізняються від $22–32 млрд. Поясни, які категорії вони включають і чому їхні оцінки вищі».
Так можна знайти Gartner із $644 млрд і зрозуміти, що він використовує набагато ширше визначення «spending».
Цей крок важливий, тому що без нього Perplexity може просто зібрати три схожі за величиною оцінки та створити ілюзію консенсусу.
8. Перевірити незалежність джерел
Тепер потрібно запитати: «Чи є ці три оцінки незалежними? Чи не використовують вони одну й ту саму базову статистику або джерела?»
Це особливо важливо для market research. Якщо три звіти використовують одну й ту саму оцінку від великого постачальника даних, то: 3 звіти ≠ 3 незалежні підтвердження.
Для якісного дослідження бажано мати різні методологічні підходи.
9. Перевірити кожну цифру безпосередньо
Наприкінці можна дати Perplexity контрольний запит: «Для кожної цифри з попередньої відповіді покажи точне першоджерело. Вкажи назву звіту, дату публікації, сторінку або розділ, де наведено оцінку. Якщо цифра є прогнозом, познач її як прогноз. Якщо це оцінка фактичного 2025 року — познач як ретроспективна оцінка».
Це вже значно надійніший результат.
Фінальний результат
Після всіх цих кроків хороший висновок виглядав би приблизно так:
«Не існує однієї загальноприйнятої цифри «розміру світового ринку генеративного AI у 2025 році». Різні дослідницькі організації рахують різні категорії. Grand View Research оцінює generative AI market у $22,2 млрд, MarketsandMarkets — у $32,2 млрд, тоді як Menlo Ventures оцінює корпоративні витрати на GenAI у $37 млрд. Gartner дає значно вищу оцінку — $644 млрд, але його показник охоплює значно ширше поняття GenAI spending, включно з hardware, software та IT services.»
І саме цей спосіб роботи добре демонструє, навіщо Perplexity потрібен для досліджень.
Він не просто відповідає на запит: «Скільки коштував ринок GenAI?»
А допомагає пройти ланцюжок: питання → визначення терміна → пошук джерел → порівняння методологій → перевірка першоджерел → пошук суперечностей → фінальний висновок.
Сподіваємось, що на прикладі нам вдалося продемонструвати вам, як сервіс знаходить цифри та продемонструвати головний принцип «не довіряй готовій відповіді — перевір, що саме стоїть за нею».
А як ви використовуєте Perplexity у своїй роботі? Діліться своїми прийомами, корисними промптами та помилками в коментарях.